
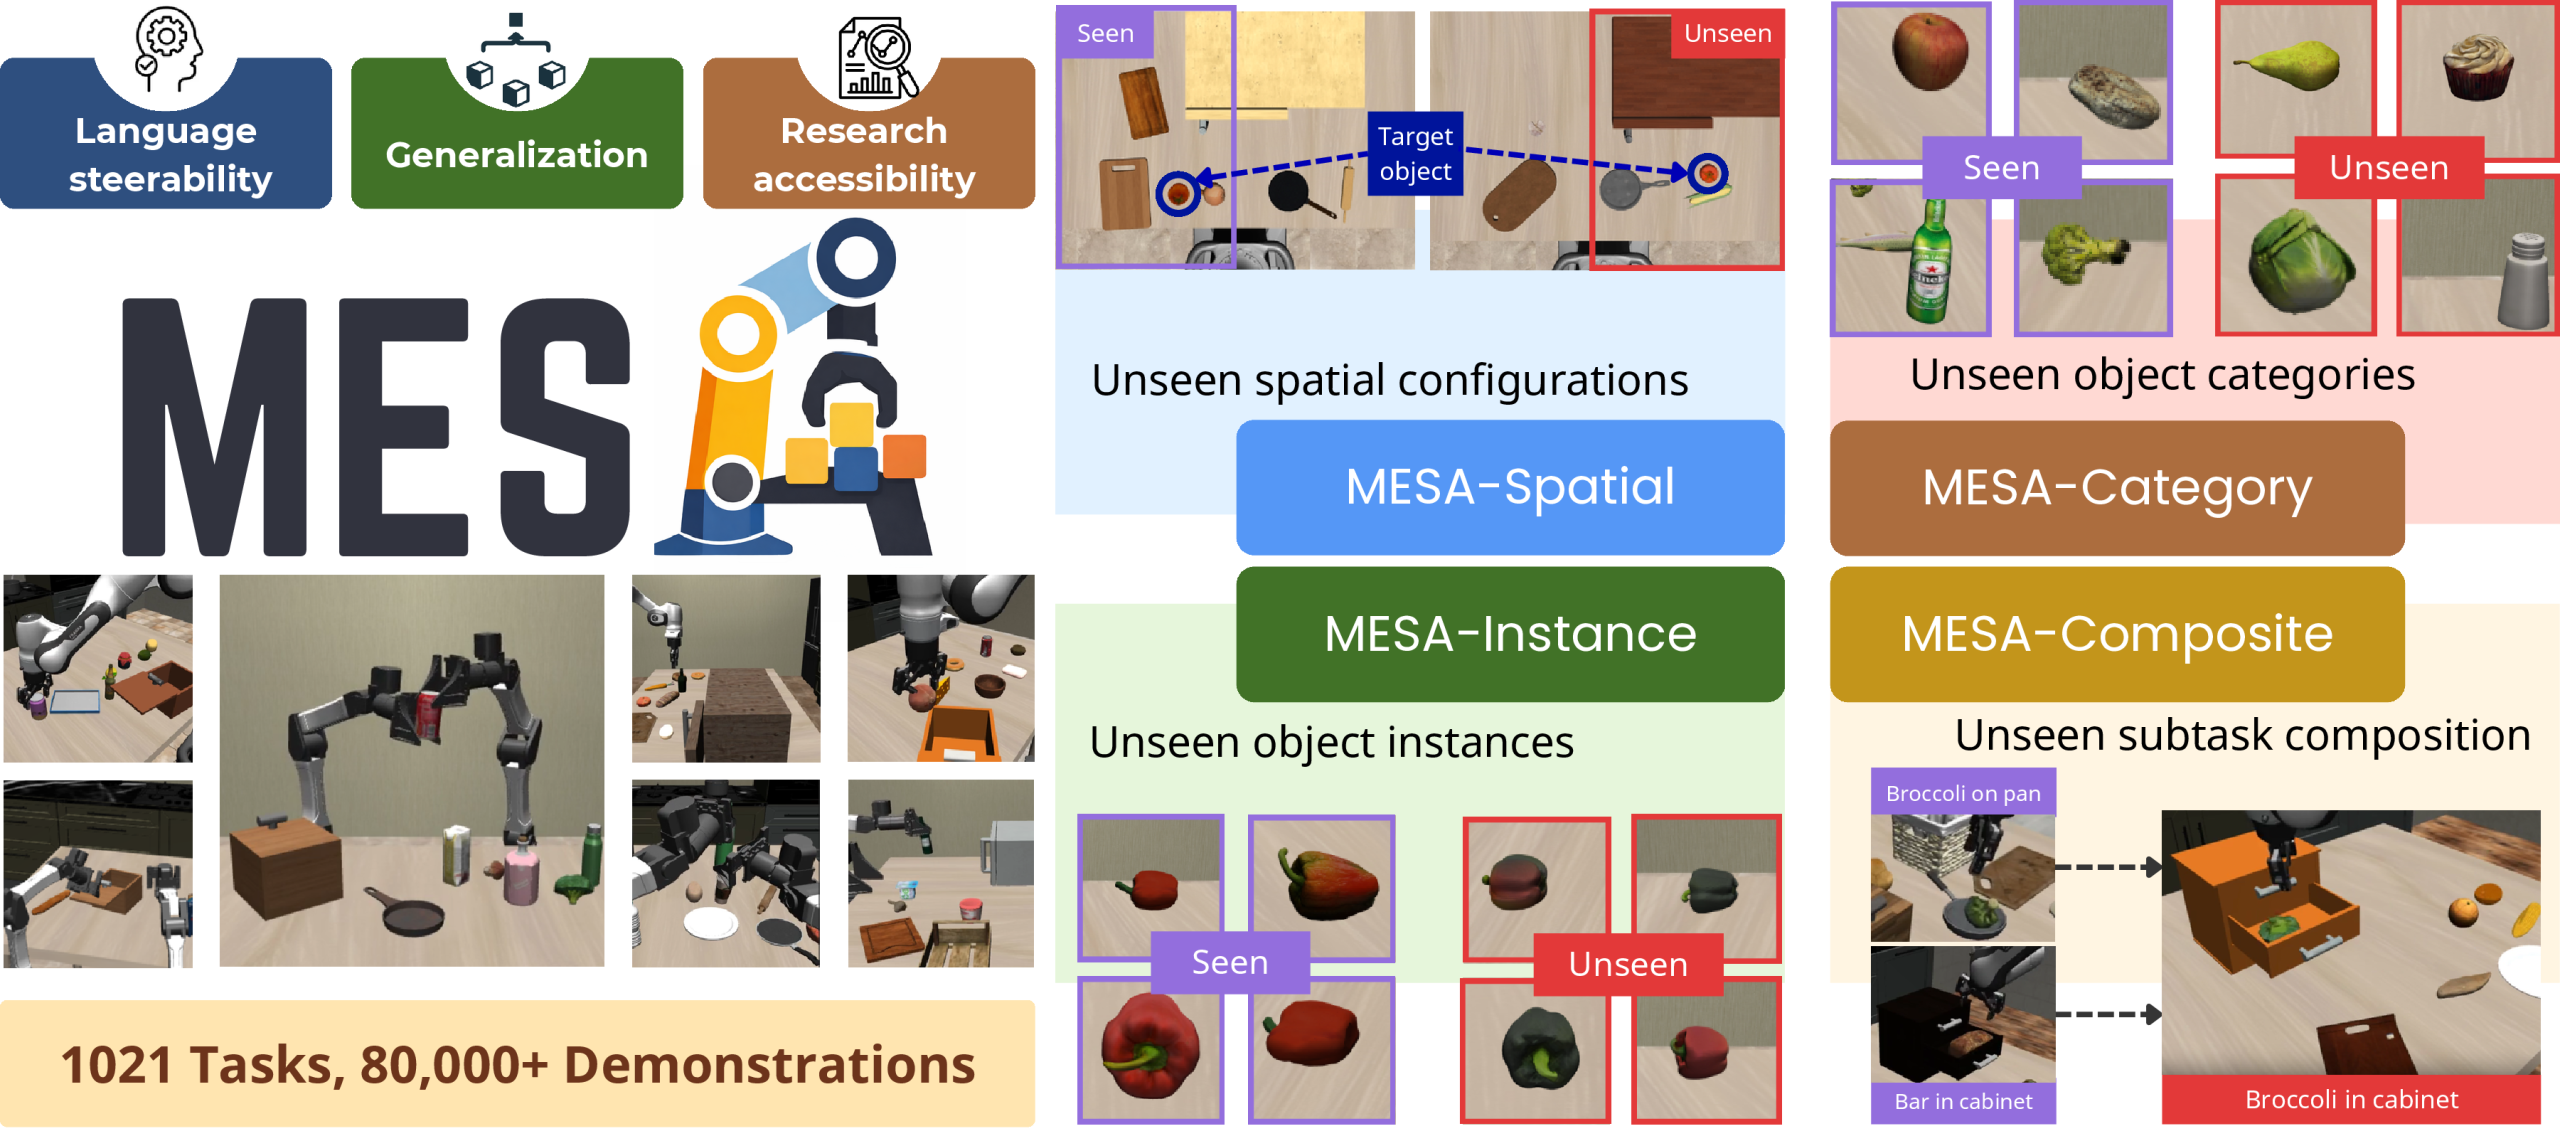
机器人操作泛化有了新的衡量标尺。MESA 评测框架用五个评测套件拆解语言条件策略的泛化能力:除分布内表现外,还分别测空间布局、物体实例、物体类别与子任务组合四类泛化,帮助研究者定位策略在何处、为何失效。
框架覆盖单臂 MESA 与双臂 BiMESA 两个基准,评测了扩散策略、VLM 方法与预训练 VLA 等七种基线方法,最强模型平均成功率仅为 52% 与 49%,留下了充足的改进空间。论文 11 月 3 日提交至 arXiv。
正文完
机器人操作泛化有了新的衡量标尺。MESA 评测框架用五个评测套件拆解语言条件策略的泛化能力:除分布内表现外,还分别测空间布局、物体实例、物体类别与子任务组合四类泛化,帮助研究者定位策略在何处、为何失效。
框架覆盖单臂 MESA 与双臂 BiMESA 两个基准,评测了扩散策略、VLM 方法与预训练 VLA 等七种基线方法,最强模型平均成功率仅为 52% 与 49%,留下了充足的改进空间。论文 11 月 3 日提交至 arXiv。


 智梦
很好的开源项目